GPT-6 Astra, 아르곤, 오푸스, 키미 순위가 궁금하다면 벤치마크 숫자에 앞서 공개 근거와 미확인 정보를 구분하세요. 코딩·문서 작업별 평가법과 월 비용 계산 예시를 정리했습니다. 현재 확인 가능한 자료의 한계도 짚어봅니다.
“지금 AI 모델 1등이 뭐예요?” 도구를 고르려는데 순위표마다 답이 다르면 답답하시죠. Wow, 2026년 11월 AI 모델 성능 순위를 둘러싼 논쟁은 뜨겁지만, 이제는 순위 자체보다 내 작업에서 어떤 결과가 나오는지가 더 중요한 시점입니다. GPT-6 Astra, 아르곤, 오푸스, 키미를 한 줄로 세우기 전에 공개 근거부터 분리해 볼게요. 🚀
⚡ Tech Summary: 지금 확인할 수 있는 것과 없는 것
OpenAI가 소개한 GPT-6 Astra 자료에는 내부 평가 ExploitBench(2026년 6월~8월) 결과가 등장합니다. 직전 3개월간의 취약점을 활용한 익스플로잇 개발 역량을 평가했으며, Astra가 GPT-5.6 Sol보다 적은 출력 토큰으로 더 높은 임의 코드 실행률을 보였다는 설명입니다.
흥미로운 신호지만, 특정 내부 평가에서의 비교를 코딩·글쓰기·검색을 통틀어 “전체 1위”라는 뜻으로 읽으면 곤란합니다. 이 평가는 OpenAI가 직접 구축한 내부 평가이고, 독립 기관이 같은 조건으로 재현했는지는 제공된 출처에서 확인되지 않습니다. 아르곤·오푸스·키미의 동일 조건 점수나 통합 순위도 마찬가지고요. 어느 회사의 어떤 버전을 가리키는지도 먼저 확정해야 합니다.
순위표보다 UX: 같은 일을 맡겼을 때 무엇이 달라질까?
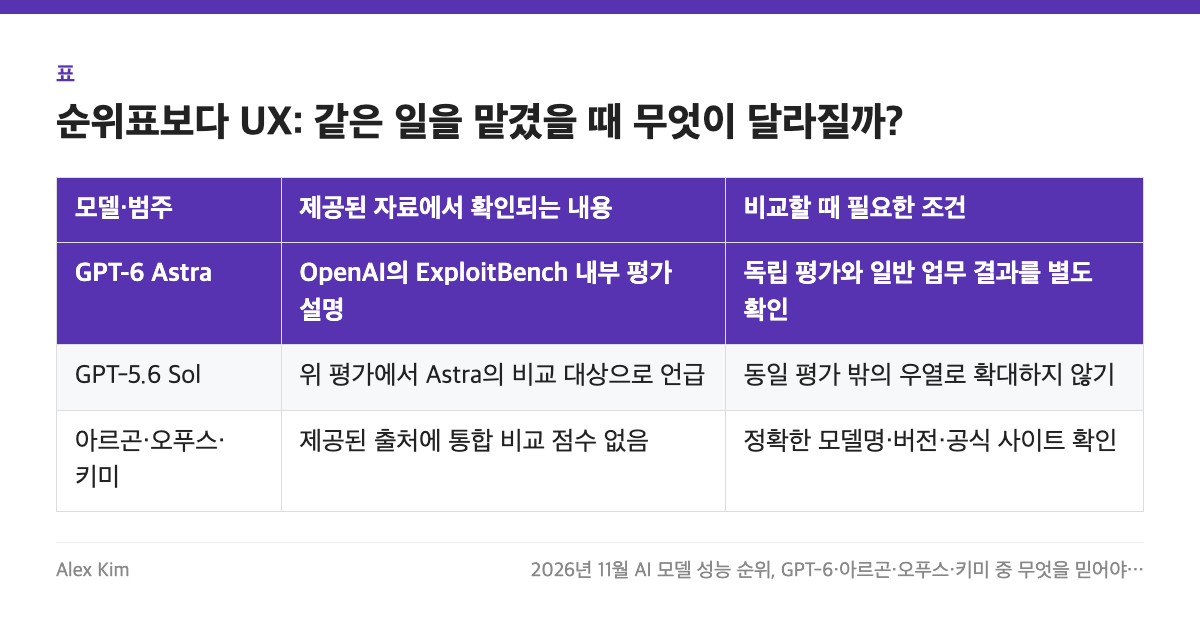
사용자 입장에서 중요한 건 벤치마크 숫자보다 재작업 횟수, 응답 대기, 검증 부담입니다. 개발자 입장에서는 코드가 그럴듯한지보다 테스트를 통과하는지가 핵심이고, 문서 작업이라면 인용 출처가 실제 문장을 뒷받침하는지를 봐야 하죠. 이 관점으로 비교하면 표가 훨씬 쓸모 있어집니다. ✨
| 모델·범주 | 제공된 자료에서 확인되는 내용 | 비교할 때 필요한 조건 |
|---|---|---|
| GPT-6 Astra | OpenAI의 ExploitBench 내부 평가 설명 | 독립 평가와 일반 업무 결과를 별도 확인 |
| GPT-5.6 Sol | 위 평가에서 Astra의 비교 대상으로 언급 | 동일 평가 밖의 우열로 확대하지 않기 |
| 아르곤·오푸스·키미 | 제공된 출처에 통합 비교 점수 없음 | 정확한 모델명·버전·공식 사이트 확인 |
따라서 현시점의 비교 결론은 “검증된 통합 1위는 이 자료만으로 정할 수 없다”입니다. 특히 Astra와 이전 모델의 보안 평가 차이를 다른 업체 모델의 성능으로 이어 붙이는 비교는 피해야 합니다. 보안 익스플로잇 평가가 강하다고 해서 장문 요약이나 한국어 문서 교정까지 강하다는 보장은 없으니까요. 이전 버전과의 비교든 경쟁사와의 비교든, 같은 과제·같은 채점 기준이라는 전제가 깨지면 숫자는 참고용에 그칩니다.
내 업무에서 ‘1위’를 찾는 작은 테스트 설계
그럼 어떻게 고를까요? 동일한 프롬프트와 동일한 채점 기준을 준비하면 됩니다. 아래 수치는 공개 벤치마크가 아니라 개인 평가를 위한 가정입니다.
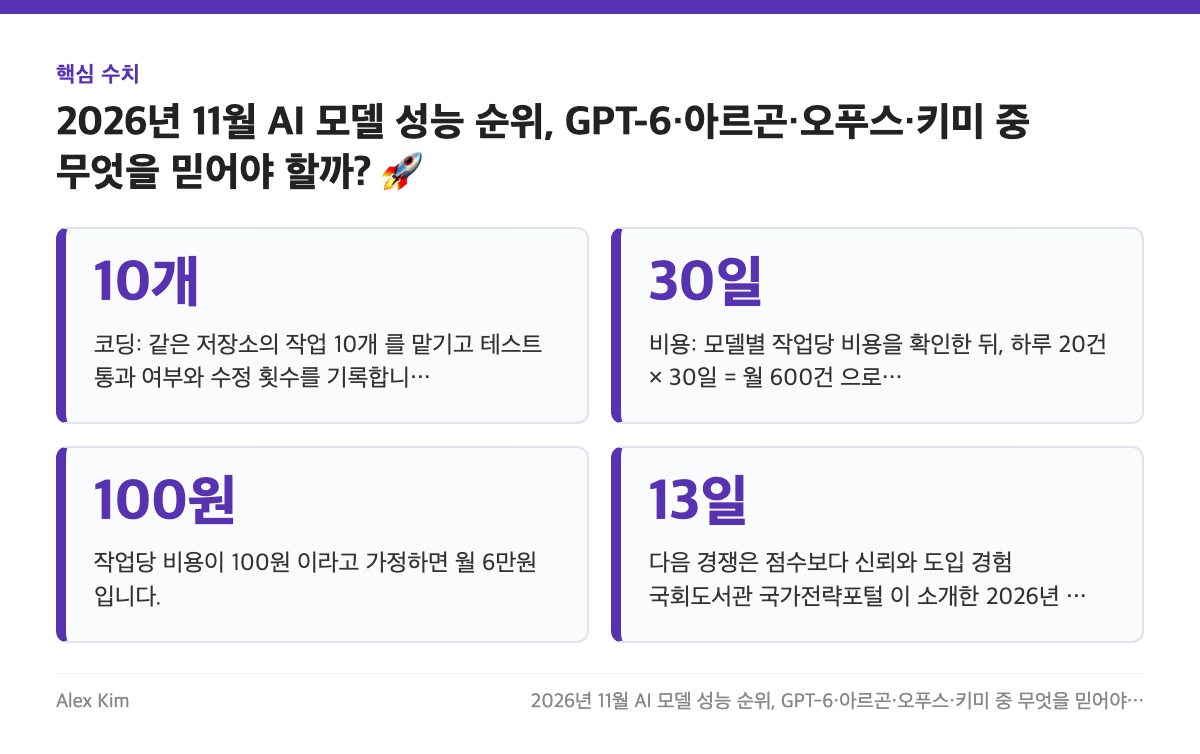
- 코딩: 같은 저장소의 작업 10개를 맡기고 테스트 통과 여부와 수정 횟수를 기록합니다.
- 문서: 출처 확인이 필요한 질문 10개로 사실 오류와 근거 누락을 셉니다.
- 비용: 모델별 작업당 비용을 확인한 뒤, 하루 20건 × 30일 = 월 600건으로 환산합니다. 작업당 비용이 100원이라고 가정하면 월 6만원입니다. 실제 가격과 사용량 제한은 각 모델의 공식 사이트에서 확인하세요.
기록은 아래처럼 단순한 로그 형태면 충분합니다. 모델 이름 칸만 바꿔 같은 과제를 반복하세요.
task_id, model, passed_tests(Y/N), retries, minutes_to_accept, notes
T01,    model_A, Y, 1, 12, "엣지 케이스 누락 후 수정"
T01,    model_B, N, 3, 25, "테스트 실패 반복"
응답이 조금 빠른 모델이라도 검토가 반복되면 UX는 나빠질 수 있습니다. 반대로 최고 점수가 아니어도 반복 업무에서 안정적이라면 더 나은 선택일 수 있죠. Game Changer는 ‘만능 1등’이 아니라 작업별로 모델을 배치하는 방식일지도 모릅니다.
다음 경쟁은 점수보다 신뢰와 도입 경험
국회도서관 국가전략포털이 소개한 2026년 4월 13일 스탠퍼드 HAI의 AI 지수 보고서 관련 자료는 AI를 기술을 넘어 국가 시스템의 인프라로 바라봅니다. 모델 경쟁도 단일 점수에서 접근성, 운영 비용, 안전성까지 넓어질 가능성이 있습니다.
⚡ Tech Summary: GPT-6 Astra의 공개 설명은 눈여겨볼 만하지만, 아르곤·오푸스·키미까지 포함한 2026년 11월 확정 순위를 제시할 근거는 부족합니다. 여러분이라면 코딩 정확도, 문서 신뢰성, 비용 중 무엇을 가장 먼저 비교하시겠어요? 댓글로 알려주세요! 🚀
참고 자료
- OpenAI — GPT-6 Astra 소개 및 내부 평가 설명
- 국회도서관 국가전략포털 — 2026년 AI 지수 보고서 관련 소개