인텔 AI 서밋의 개방형 이기종 컴퓨팅 전략을 에이전틱 AI 작업 흐름으로 풀어봅니다. CPU·GPU·NPU 역할과 단일 플랫폼 대비 장단점, 도입 전 측정할 지연시간·비용·호환성 기준을 한눈에 정리했어요.
AI 에이전트가 검색하고, 코드를 실행하고, 결과를 다시 검증하는 동안 인프라 비용과 응답시간은 어떻게 달라질까요? 모델 성능만 보고 시스템을 골랐다면 놓치기 쉬운 질문입니다. 인텔 AI 서밋의 개방형 이기종 컴퓨팅이라는 화두가 흥미로운 이유도 여기에 있어요. 하나의 칩을 밀기보다 작업에 맞는 자원을 조합하자는 접근이니까요. Wow, 에이전틱 AI 시대에는 이 선택이 UX를 바꿀 수도 있습니다. ✨
에이전트가 움직이면, 병목도 움직인다
일반적인 챗봇은 질문과 답변 한 번에 주목하기 쉽습니다. 반면 에이전트는 요청을 쪼개고 도구를 호출한 뒤 결과를 확인하는 흐름을 반복할 수 있죠. 이때 모든 단계를 같은 가속기로 처리하는 것이 항상 유리한지는 별개의 문제입니다. 모델 추론만 빠르다고 해서 전체 흐름이 빨라지는 것은 아니거든요. 검색 결과를 파싱하고, 코드를 샌드박스에서 실행하고, 로그를 남기는 구간은 GPU보다 범용 연산에 가까운 경우가 많습니다.
- CPU: 작업 분기, 도구 실행, 데이터 전처리처럼 제어가 중요한 단계
- GPU: 병렬 처리가 중요한 대규모 모델 추론 단계
- NPU: 지원 소프트웨어가 갖춰진 기기에서의 온디바이스 AI 작업 후보
핵심 UX는 ‘어떤 칩이 더 빠른가’보다 사용자가 기다리는 전체 시간이 줄어드는가입니다. 국내 AI-반도체 이니셔티브 역시 차세대 개방형 AI 아키텍처와 소프트웨어 핵심기술 개발을 과제로 제시합니다. 또 대외경제정책연구원의 트럼프 2기 AI 정책 분석은 AI 패권의 기반으로 인프라와 개방형 디지털 생태계를 함께 짚습니다. 개방성이 업계 전반의 화두라는 배경으로 참고할 만합니다. 다만 이런 정책 방향이 인텔의 특정 제품 성능을 입증하는 것은 아닙니다.
개방형 전략 vs 단일 플랫폼, 무엇을 비교할까?
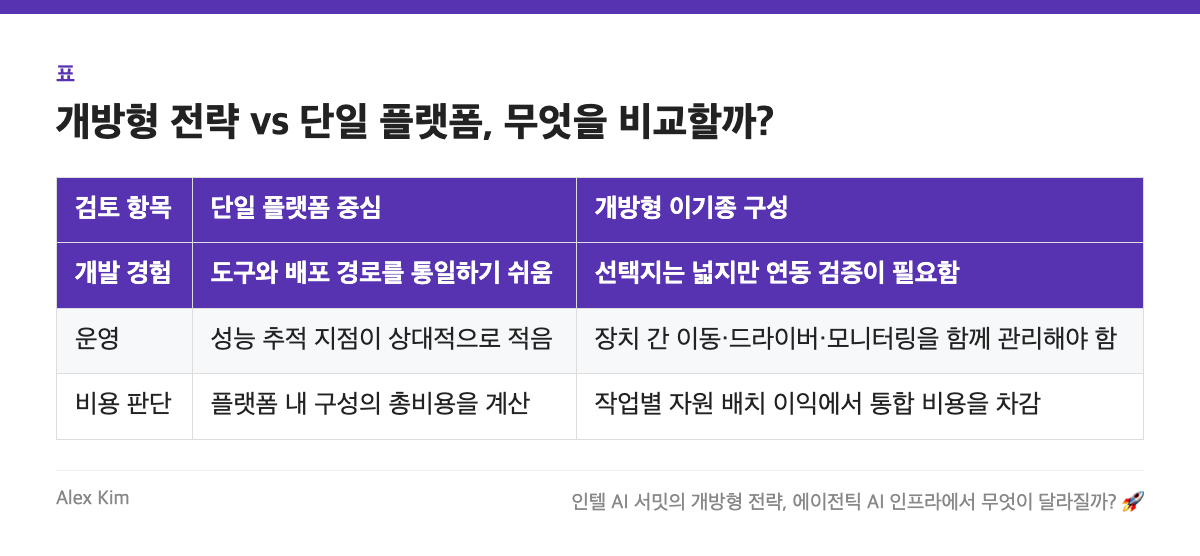
인텔이 내세우는 방향을 평가할 때는 경쟁사의 특정 GPU와 이름표만 맞붙여선 부족합니다. 개발자에게는 코드를 옮기는 난도, 운영팀에는 장애를 추적하는 난도가 더 크게 다가올 수 있거든요. 이전 세대 서버 중심 구성과 비교하면, 이기종 구성은 선택지가 늘어난 만큼 검증할 조합도 함께 늘어납니다.
| 검토 항목 | 단일 플랫폼 중심 | 개방형 이기종 구성 |
|---|---|---|
| 개발 경험 | 도구와 배포 경로를 통일하기 쉬움 | 선택지는 넓지만 연동 검증이 필요함 |
| 운영 | 성능 추적 지점이 상대적으로 적음 | 장치 간 이동·드라이버·모니터링을 함께 관리해야 함 |
| 비용 판단 | 플랫폼 내 구성의 총비용을 계산 | 작업별 자원 배치 이익에서 통합 비용을 차감 |
단일 플랫폼은 일관성이 강점이고, 이기종 구성은 workload별 최적화 가능성이 매력입니다. 하지만 ‘개방형’이라는 말만으로 코드 이식성이나 성능이 보장되지는 않습니다. 이기종 컴퓨팅 환경의 시스템 성능 검증 연구처럼, 실제 구성에서 benchmark를 확인하는 과정이 필요합니다. 개발자 입장에서는 특정 벤더 전용 API에 얼마나 의존하는지, 표준 런타임으로 모델을 옮길 수 있는지가 체감 난도를 좌우합니다.
도입 전에는 이 숫자부터 보세요 ⚡
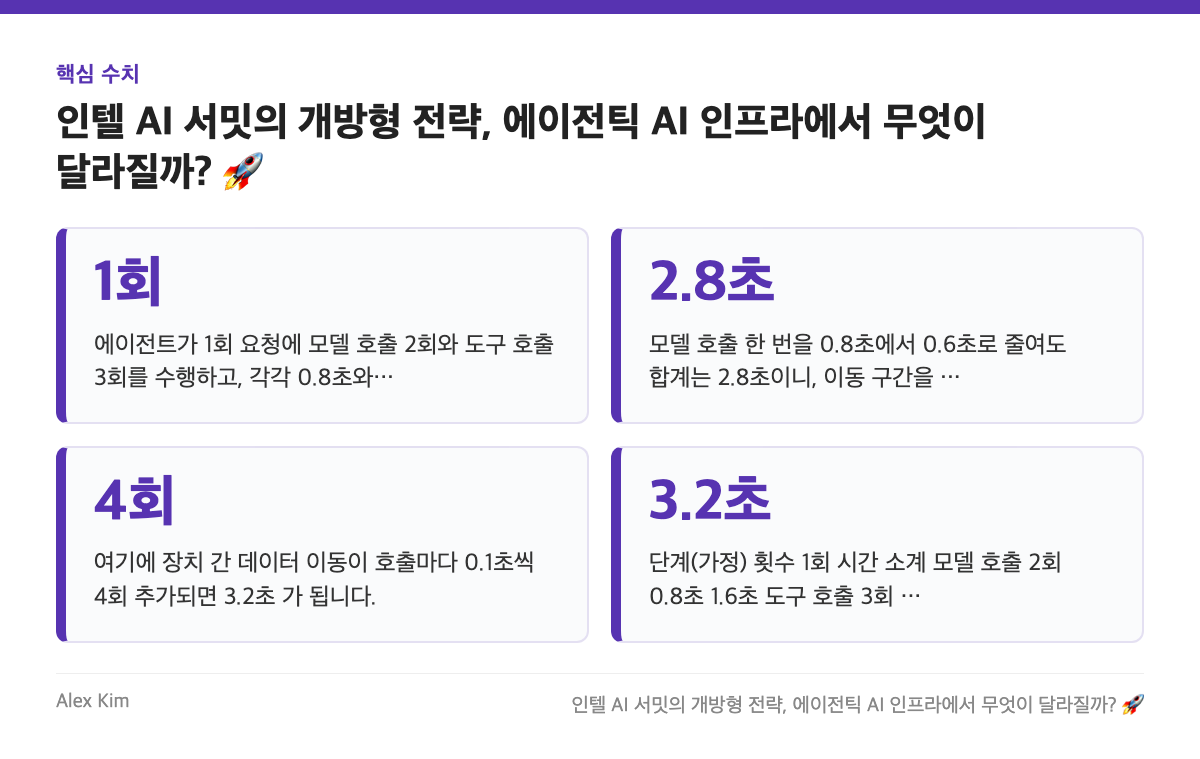
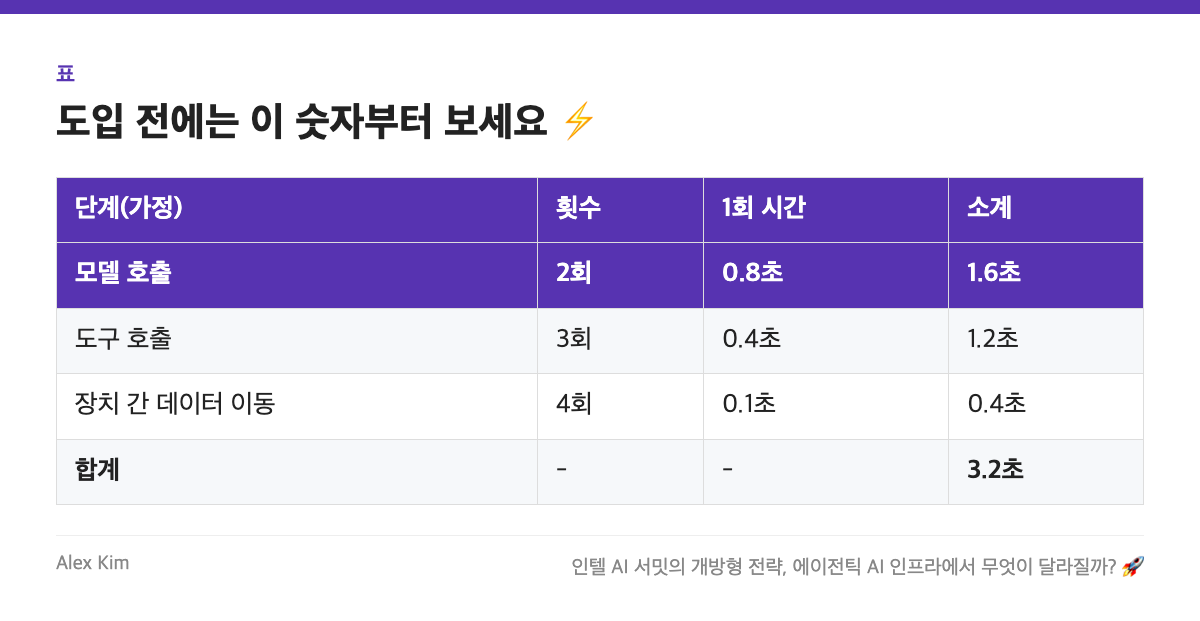
예를 들어 아래는 제품 실측이 아닌 가정입니다. 에이전트가 1회 요청에 모델 호출 2회와 도구 호출 3회를 수행하고, 각각 0.8초와 0.4초가 걸린다면 순차 실행 시간은 2 × 0.8 + 3 × 0.4 = 2.8초입니다. 여기에 장치 간 데이터 이동이 호출마다 0.1초씩 4회 추가되면 3.2초가 됩니다. 가속기 자체가 빨라도 연결 비용 때문에 체감 반응이 나빠질 수 있다는 뜻이죠.
| 단계(가정) | 횟수 | 1회 시간 | 소계 |
|---|---|---|---|
| 모델 호출 | 2회 | 0.8초 | 1.6초 |
| 도구 호출 | 3회 | 0.4초 | 1.2초 |
| 장치 간 데이터 이동 | 4회 | 0.1초 | 0.4초 |
| 합계 | - | - | 3.2초 |
이 가정에서 이동 비용 0.4초는 전체의 12.5%입니다. 모델 호출 한 번을 0.8초에서 0.6초로 줄여도 합계는 2.8초이니, 이동 구간을 줄이는 설계가 더 큰 효과를 낼 수도 있겠죠. 물론 실제 값은 환경마다 다릅니다.
- 지연시간: 첫 응답뿐 아니라 도구 호출을 포함한 요청 전체를 측정
- 비용: 칩 가격이 아닌 전력·개발·운영을 합친 총비용으로 비교
- 호환성: 모델 변경과 장치 교체 때 수정해야 할 코드 범위 확인
개발자라면 동일한 에이전트 workflow를 두 구성에서 실행하고, 결과 품질까지 맞춘 뒤 비교하는 편이 좋습니다. 세부 지원 범위와 최신 성능 수치는 공식 사이트에서 확인해야 합니다.
⚡ Tech Summary: 승부처는 ‘조합’보다 ‘검증’
에이전틱 AI가 확산될수록 하나의 빠른 칩보다 작업을 적절한 곳에 배치하고 전체 흐름을 관측하는 능력이 중요해질 가능성이 있습니다. 인텔의 개방형 이기종 전략은 그런 점에서 주목할 만한 제안입니다. 다만 앞으로의 Game Changer 여부를 가를 요소는 슬로건이 아니라 개발 도구의 완성도와 반복 가능한 성능 측정일 거예요. 여러분이라면 에이전트 인프라를 고를 때 속도, 이식성, 운영 편의성 중 무엇을 먼저 보시겠어요? 🚀
참고 자료
- AI-반도체 이니셔티브 — 개방형 AI 아키텍처 관련 정책 자료
- 대외경제정책연구원 — 트럼프 2기 AI 정책 변화와 시사점
- 한국학술지인용색인 — 이기종 컴퓨팅 성능 검증 관련 연구
⚠️ 주의·한계: 위 비교는 인텔 AI 서밋 발표 제품의 실측 결과가 아니며, 계산 수치는 설명을 위한 가정입니다. 제품별 지원 기능·출시 상태·성능은 미검증이므로 공식 사이트와 실제 도입 환경에서 확인하세요.